上两篇写开源生图模型的时候,评论区有朋友问老路能不找个MinimaxH3越狱版在低显存配置能用的模型和工作流,实话说,在AI视频这块,老路研究的不多,之前也试过其他大佬分享的整合包和工作流,不过基本上也都是OOM,官方的工作流也尝试过,能跑,但非常慢,所以也就放着没再折腾了。
这次既然有朋友来问了,那老路必须宠粉,研究了2天,找到了2个方法(工作流),在老路的笔记本(4060 8G+32G内存)跑成功了,2分钟出片,今天来分享一下全过程。老规矩,不喜欢看字的直接拉到最后看视频,整理好的网盘下载也在最后。
一、还是得介绍下Mimimax H3
MiniMax H3 不是小厂玩的,是**稀宇科技(MiniMax)**的看家视频模型,2026 年 8 月 3 日开的源。
它有几个特点,决定了它跟以前那些开源视频模型不是一个路子:
| 项目 | 情况 |
|---|---|
| 参数量 | 33B 全模态模型 |
| 能力 | 文本、图像、视频、音频四种输入统一理解 |
| 输出 | 视频 + 原生立体声音频,在同一个 MP4 里 |
| 时长 | 5–15 秒 |
| 分辨率 | 本地权重原生 768p 短边;2K 走官方托管服务 |
| 开源日期 | 2026-08-03 |
最值得说的是”原生音频”。 一般视频模型生成完画面,再另外配音配乐——声音和画面对不上是常事。H3 是语音、音效、音乐跟着画面一次前向传播出来,天生同步。
而且它真吃输入音频——你给它一段音轨,它按这个音轨来生成,而不是覆盖掉或丢掉。
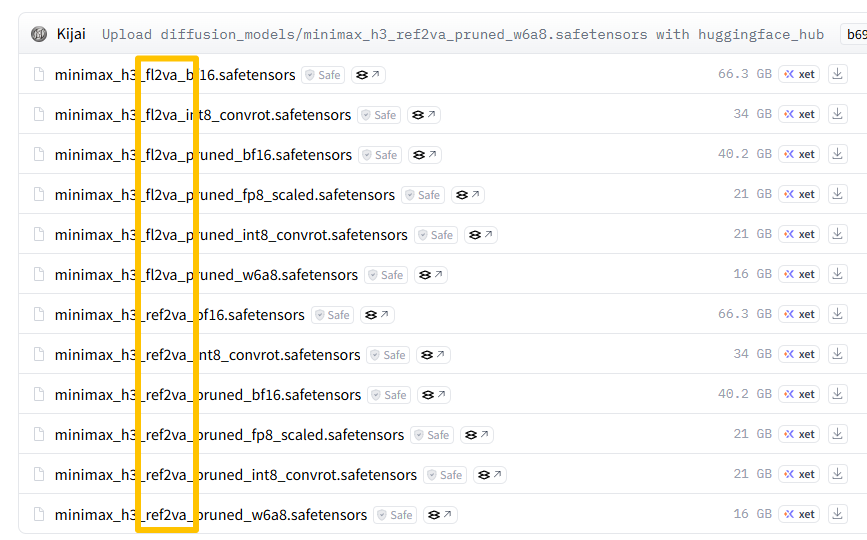
两个模型变体,覆盖所有玩法:
| 变体 | 用途 |
|---|---|
| FL2VA | 文生视频,可选首帧 / 尾帧控制 |
| Ref2VA | 全模态参考:最多 9 张图 + 3 段视频 + 3 段音频当参考 |
Ref2VA 那个能力挺凶的——角色一致性、视频编辑、动作参考、片段续接,都靠它。
知道了这两个变体,Huggingface上的模型清单,大家也就知道是做什么的了
二、8G 显存到底靠什么跑起来的
这是全篇最关键的一节,先说清楚原理,后面步骤你才看得懂。
33B 的模型,为什么 8G 显存能塞进去? 靠三件事叠加:
第一件:用 pruned(剪枝)检查点
官方提供两套权重。pruned 版本做了个聪明的处理——用一张很短的共享曲线基表(adaln_t_table,1025 个曲线采样 × 8 个基列)替掉了时间嵌入器和全宽 adaln 权重,ComfyUI 直接从 checkpoint 里读这张表。
效果就是检查点小一大圈。 对比一下真实的文件体积,从 66 GB 砍到 21 GB,这就是能进小显存的第一道门。
所以,下载的时候选哪个,大家就清楚了
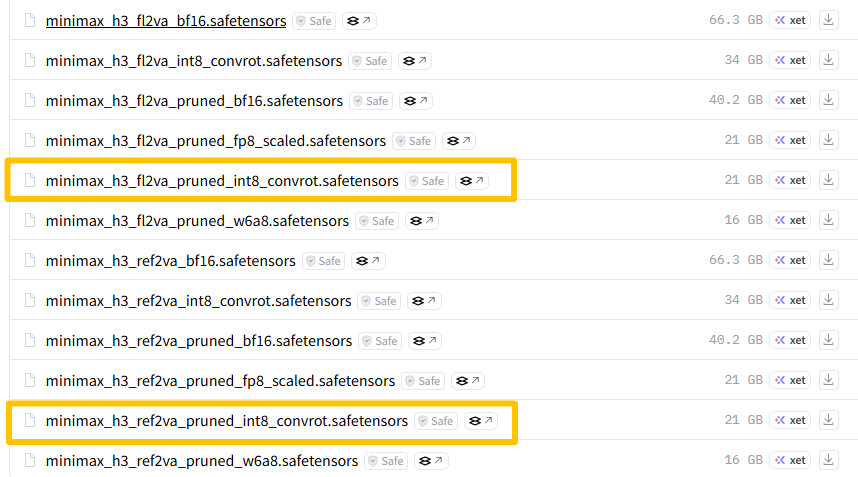
Huggingface模型下载页面
第二件:用 nvfp4版本的文本编码器
文本编码器是 Qwen3-VL-32B——32B 的编码器,本身就是个大头,用nvfp4版本即可
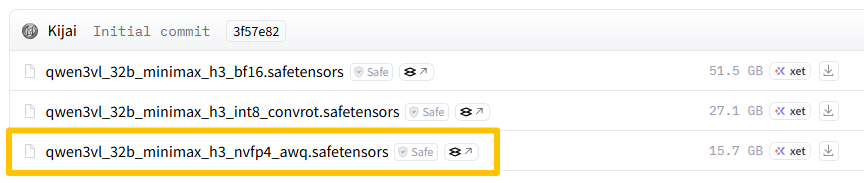
nvfp4编码器15.7 GB。 而且 ComfyUI 的流程是「编码完就把编码器卸掉、再加载主模型去噪」——两者不同时占显存,这是 8G 能跑的关键机制。
文本编码器Huggingface下载页面
顺便说大家最关心的“无审查”,Minimax H3 还有之前博客介绍的 Qwen Image 2.1无审查生图模型 都是通过文本编码器的“优化”来实现的,和主模型无关,所以,我们只需要找到一个Minimax H3对应的无审查文本编码器就可以了,如下,同样是15.7G,但是它是没限制的
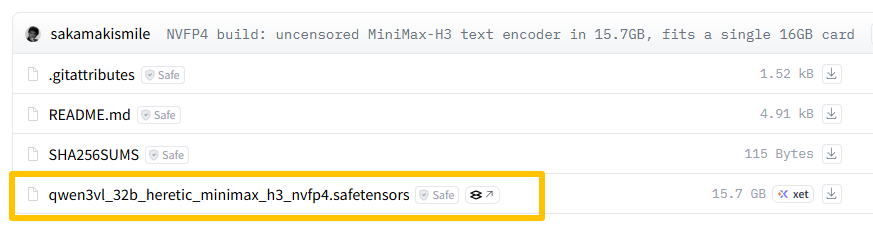
无审查文本编码器Huggingface下载页面
第三件:加速 LoRA 把步数压下来
视频模型慢,一半慢在步数多。加速 LoRA 就是干这个的:
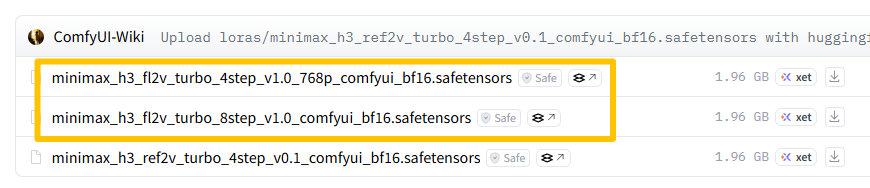
只有 1.96 GB,挂上去就能把采样步数从几十步压到 4 步或 8 步。这就是”2 分钟出片”的核心——不是硬件变强了,是少了大量的采样往返。
要注意,官方说明里还提了个容易被忽略的硬要求:
“Plan for 32–64 GB of system RAM — layers that don’t fit in VRAM are staged from RAM.”
显存不够的部分是拿内存顶的。 所以别只盯显存,系统内存也得够,不然照样跑不动,所以,你的电脑至少32G内存。
三、文件清单
老路整理好了文件清单,按这个目录下载安装模型即可
ComfyUI/
└── models/
    ├── diffusion_models/ 主模型
    │   ├──  minimax_h3_fl2va_pruned_int8_convrot.safetensors 文生视频
    │   └──  minimax_h3_ref2va_pruned_int8_convrot.safetensors 全模态参考生视频
    ├── text_encoders/ 文本编码器
    │   ├── qwen3vl_32b_heretic_minimax_h3_nvfp4.safetensors  越狱版
    │   └── qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors  官方版
    ├── vae/
    │   ├── minimax_h3_video_vae_int8_convrot.safetensors  视频vae,要注意,不少大神用的是b16精度的,容易OOM
    │   └── minimax_h3_audio_vae_fp32.safetensors  音频vae
    └── loras/
        └── minimax_h3_fl2v_turbo_8step_v1.0_comfyui_bf16.safetensors  加速Lora
注意有两个 VAE,都得下——一个是视频 VAE,一个是音频 VAE。H3 要出立体声,音频 VAE 不能少。
下载量提醒,这一套下来要60G,注意你的硬盘空间~
四、ComfyUI 工作流(2个,第二个更简单)
1. ModelTC/Minimax-H3-Turbo工作流
直接照着下面截图配置模型即可
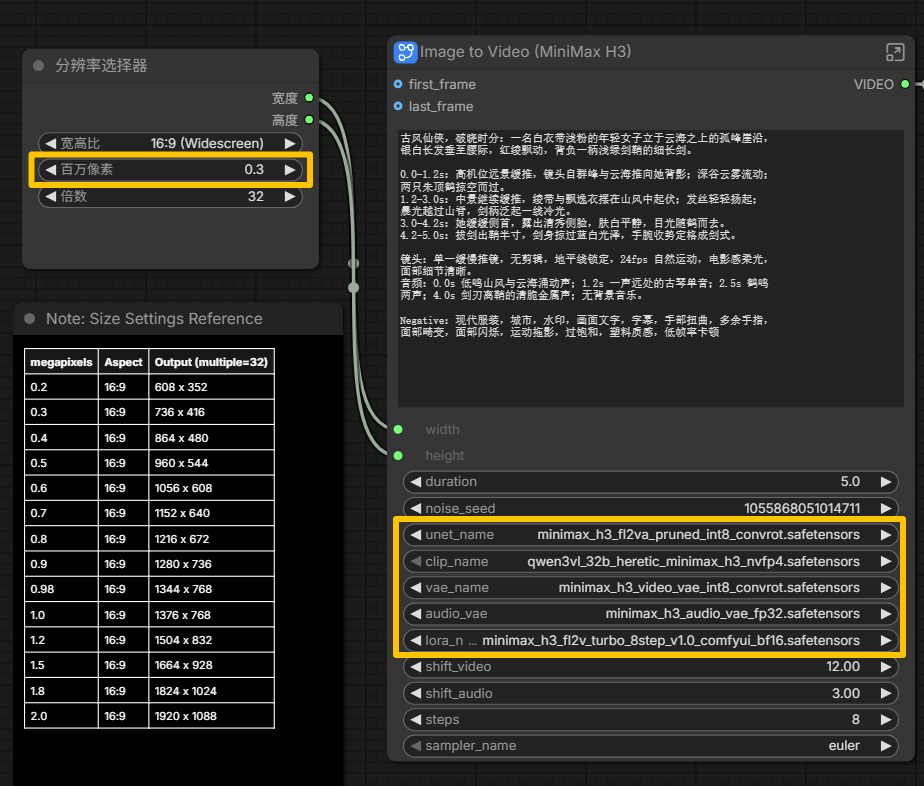
| 项目 | 实际用的 |
|---|---|
| 显存 | 8 GB |
| 主模型 | pruned int8 检查点 |
| 加速 LoRA | fl2v_turbo_8step_v1.0(8 步档) |
| 采样步数 | 8 步 |
| 分辨率 | 736 × 416(约 0.3 MP) |
| 视频时长 | 5 秒 |
| 音频 | 原生立体声,正常出 |
| 出片耗时 | 约 2 分 |
实际视频效果
提示词参考如下:
古风仙侠,破晓时分:一名白衣带浅粉的年轻女子立于云海之上的孤峰崖沿,
银白长发垂至腰际,红绫飘动,背负一柄浅绿剑鞘的细长剑。

0.0-1.2s:高机位远景缓推,镜头自群峰与云海推向她背影;深谷云雾流动;
两只朱顶鹤掠空而过。
1.2-3.0s:中景继续缓推,绫带与飘逸衣摆在山风中起伏;发丝轻轻扬起;
晨光越过山脊,剑柄泛起一线冷光。
3.0-4.2s:她缓缓侧首,露出清秀侧脸,肤白平静,目光随鹤而去。
4.2-5.0s:拔剑出鞘半寸,剑身掠过蓝白光泽,手腕收势定格成剑式。

镜头:单一缓慢推镜,无剪辑,地平线锁定,24fps 自然运动,电影感柔光,
面部细节清晰。
音频:0.0s 低鸣山风与云海涌动声;1.2s 一声远处的古琴单音;2.5s 鹤鸣
两声;4.0s 剑刃离鞘的清脆金属声;无背景音乐。

Negative:现代服装,城市,水印,画面文字,字幕,手部扭曲,多余手指,
面部畸变,面部闪烁,运动拖影,过饱和,塑料质感,低帧率卡顿
ModelTC/Minimax-H3-Turbo工作流 Github仓库,不会下载的看最后的视频。
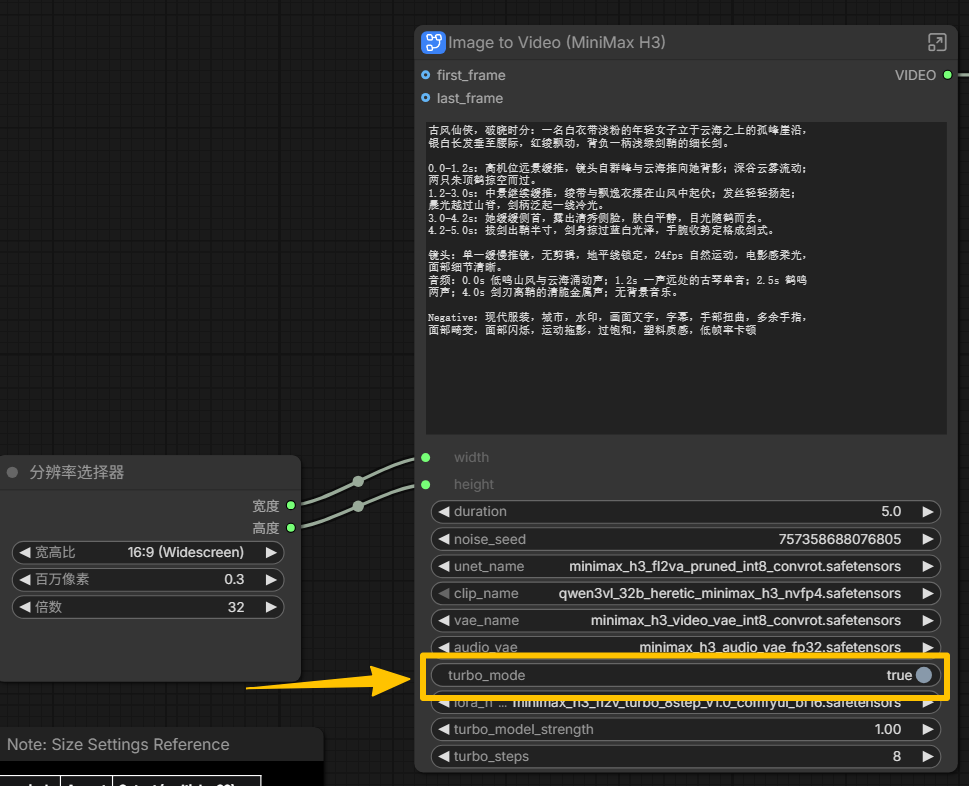
2. ComfyUI里官方Minimax H3模板共工作流
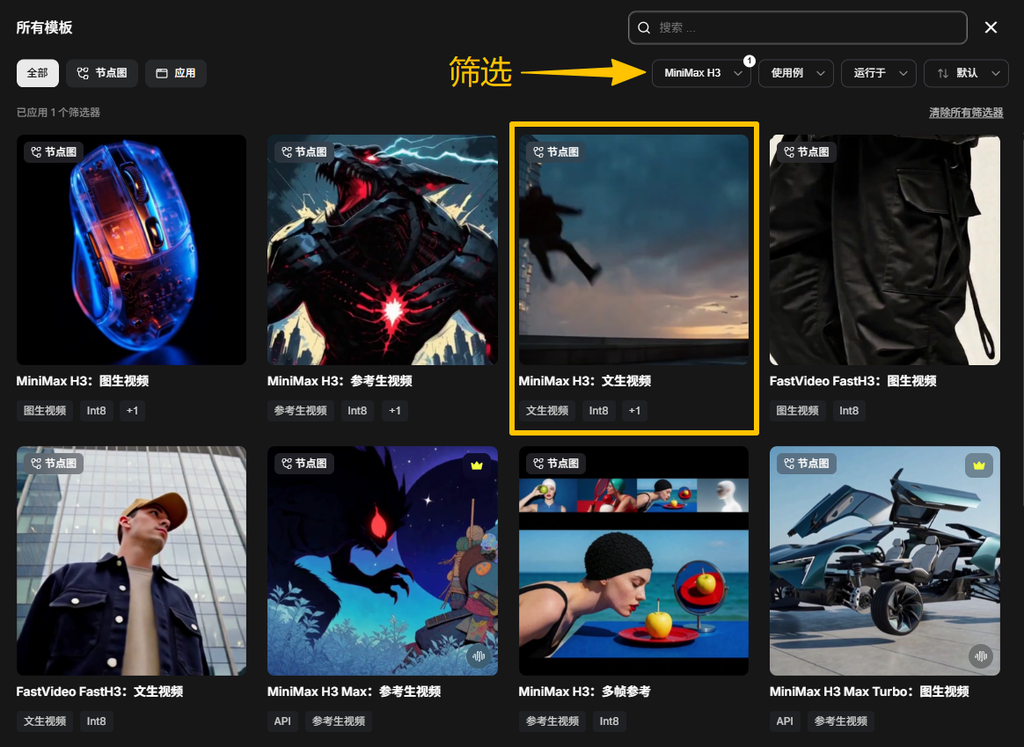
关键配置:把turbo选项打开,其他和方法1一致,如图
下面是需要说明的:
736×416 这个数,老路得说透
别被”8G 能跑 H3″这句话带跑偏。 736×416 是什么概念,老路摊开讲:
- 换算成像素约 0.3 MP
- 低于官方 12G 参考配置的 480p(854×480 约 0.41 MP)
所以它是一个”能跑通、能验证”的分辨率,不是”直接出成品”的分辨率。 拿它测试工作流、验证参数、跑通流程,完全够用;但要拿去做正式内容,你得升显存、升分辨率。
老路不想把这条藏起来——很多人写这类教程只报”跑通了”,不报跑的是什么规格,结果读者按同样的机器配,发现出来的画质跟预期差一大截。
为什么选 8 步而不是 4 步
前面列过两个档:4 步最快,8 步质量更好。老路选了 8 步,理由是:
736×416 这个分辨率本来画面细节就少,如果再用 4 步压缩采样,画质会明显发虚。这里多花的时间换回来的画面质量更值——而且老路这台机器上 8 步跑下来也就 2 分钟,速度已经够用了,没必要再往极限压。
这是个权衡思路,供你参考:当你的配置更低的时候,或者分辨率提高的时候,才轮到 4 步 LoRA 上场省时间。
8G 能跑通,但代价是明确的
| 得到 | 付出 |
|---|---|
| 显存门槛从十几 G 压到 8G | 用 pruned + int8 量化,画面细节有损 |
| 2 分钟出一条 5 秒片 | 分辨率只能到 736×416,低于官方 480p 参考 |
| 本地免费、无限跑 | 得配 32–64 GB 系统内存兜底 |
这是”穷玩”的本质:不是白拿,是拿画质换可行性。想质量好、12G 以上显存 + 分辨率拉满 + 步数加成,那才是舒服的姿势。
五、常见问题
Q:8G 显存真能跑视频?
能,但要接受代价。 老路在 8G 上跑通了,出片 2 分左右。前提是走 pruned int8 + 加速 LoRA + 系统内存够这条社区路线,而且分辨率、时长、步数都得往下压。官方标准推荐是 12G 起(480p),16–24G 才舒服。
Q:为什么官方说 12G,你能 8G?
因为官方那句原话里本来就写了 “community stacks go as low as 5–8 GB”——官方承认社区方案能压到 5–8G。老路走的正是这条路,属于优化到极限,不是轻松跑。
Q:加速 LoRA 是什么原理?
它是个蒸馏出来的小适配器,只有 1.96 GB,作用是把采样步数从几十步压到 4 步或 8 步。速度是这么来的,不是硬件变强了。代价是画质不如多步。
Q:音频是假的吗?
真的,而且这是 H3 的招牌——语音、音效、音乐跟画面在同一次前向传播里建模,不是后期拼的。它还能真正以输入音频为条件生成,而不是覆盖或丢弃。
Q:无审查版会影响画质吗?
改的是文本编码器(消融),生成模型权重不动。但要注意:作者明确说过没测”对画面的实际影响”,老路也不替这个下结论。
最后
开源视频模型能跑到 8G,这件事本身比参数表更有意义。 一年前这还不可想象。虽然代价实实在在,但门槛确实在往下掉——对预算有限的创作者来说,这就是好事。
老路整理好的模型、工作流网盘下载在这:网盘下载
本期实操视频在此~
相关阅读:
- 2026 最新无审查生图大模型 第二弹 Qwen Image 2.1 turbo,出图快5倍!8G显存本地部署实操教程
- 2026最新开源生图模型,Qwen Image 2.1越狱无审查版,8G显存全程实操,穷玩党大福音!宝宝巴士教程!
- ComfyUI 免费做封面:零成本出图全流程
- FFmpegFreeUI:免费视频处理工具
- Kaggle 免费 TPU 跑 Qwen3 27B:白嫖大模型算力
- AMD 免费 API 端点实测:DeepSeek 和 Qwen 都能白嫖
- AgentScope:免费的 AI Agent 开发平台
1 Response
[…] 8G显存实战 MiniMax H3 生成视频,加速Lora 2分出图 […]