老路之前的博客 [[AMD 官方白嫖 DeepSeek V4 Flash API]],大家反响都不错,但毕竟免费额度是厂商赏的,规则说改就改,模型也可能说换就换。今天这条不一样:Kaggle 把 TPU 白送给你用,每週 20 小时,不绑卡、不要钱,社区有大神把这一整块免费算力包装成了一个 OpenAI 兼容的大模型接口,模型是 Qwen3.8-27B,满血 bf16、26 万上下文,100+tokens/秒。老路今天带大家一起实操,老规矩,不喜欢看字的直接拉到最后看视频。
一、Kaggle和它的免费 TPU 到底是什么
Kaggle 是全球最大的数据科学 / AI 竞赛与协作平台,2017 年被 Google 收购,现在官网定位改成了「The World’s AI Proving Ground」(世界 AI 试验场),3300 万+ 用户在上面跑模型、打比赛、做评测。
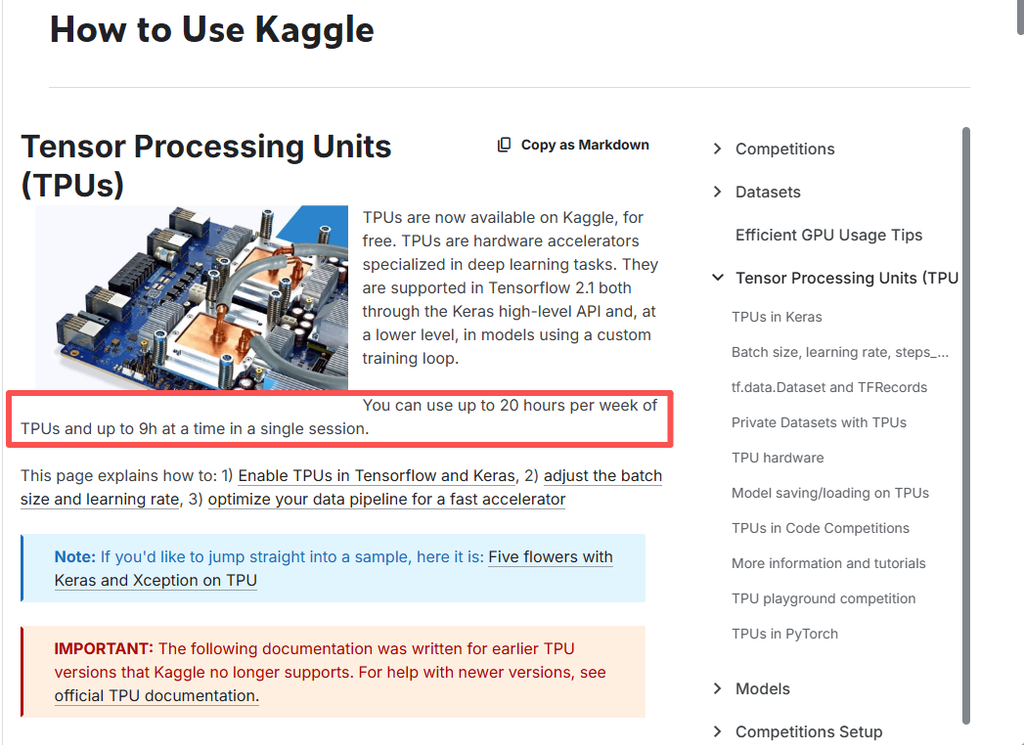
那么它的 Notebook(云笔记本)本身就是一个免费算力池。官方文档在这个页面写得明明白白:
TPUs are now available on Kaggle, for free.You can use up to 20 hours per week of TPUs and up to 9h at a time in a single session.You can add a TPU v3-8 to your Notebook for free.
翻译成人话:每周 20 小时、单次最长 9 小时的 TPU,免费。切换方式也简单,官方原文是让进 Notebook 编辑器的 Settings 面板,点 Accelerator 选 TPU,会话重启一下就开始计费——当然是免费的那种计费。
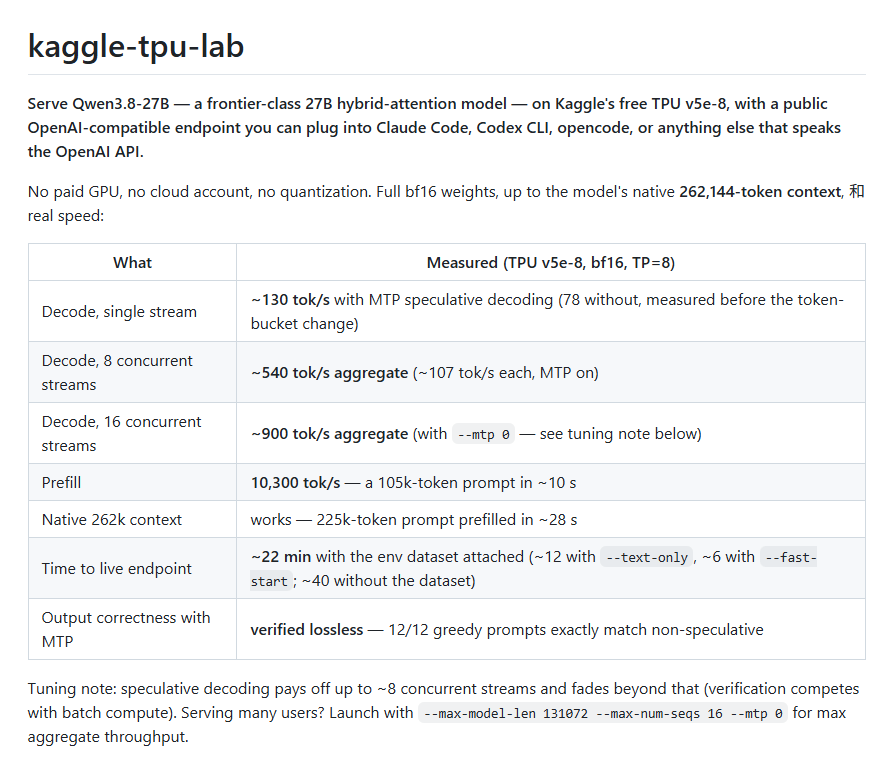
那这跟”跑 27B 大模型”有什么关系?关系在一个叫 kaggle-tpu-lab 的开源仓库上。
| 项目 | 它干了什么 |
|---|---|
| Kaggle | 提供免费 TPU 硬件 + Notebook 环境 |
| vllm-tpu 0.28.0 | 2026 年 8 月补上 Pallas 内核,让 TPU 能跑 DeltaNet 层 |
| kaggle-tpu-lab | 把 PyTorch/vLLM/权重/编译缓存打包成”一键配方”,在免费 TPU 上起 Qwen3.8-27B 服务 |
为什么是 Qwen3.8-27B?这里有个漂亮的原理:这模型 64 层里有 48 层是 gated-DeltaNet 线性注意力,只有 16 层是经典全注意力。结果是它的 KV 缓存小到 约 64 KB/token——所以一个 27B 的模型能塞进 8 张 16GB 的 TPU 芯片还有富余,撑起 131k 甚至原生 262,144 的上下文。老路看到这个数字的时候是有点意外的,毕竟本地跑 27B,光权重就是 55GB。
仓库 README 第一句就是它的卖点:Serve Qwen3.8-27B ... on Kaggle's free TPU v5e-8, with a public OpenAI-compatible endpoint you can plug into Claude Code, Codex CLI, opencode, or anything else that speaks the OpenAI API.
那 Kaggle 图啥,白送算力?这事得往母公司看——Kaggle 是 Google 家的,TPU 是 Google 自研的。用免费 TPU 把开发者、学生、研究者圈进 Google 的 AI 生态,对 Google 来说是稳赚的买卖:今天你在 Kaggle 上跑通一个 27B,明天你选云端算力的时候,脑子里第一个蹦出来的大概率就是 Google。这种级别的公司,免费额度不会像小厂一样说没就没——这也是老路愿意为这条路线写一整篇的原因:它背后站着的是 Google,跑路风险比一堆小众免费 API 低得多。
二、怎么把它变成你自己的大模型 API
先说清楚”OpenAI 兼容端点”这六个字为什么值钱。市面上绝大多数 AI 编程工具、聊天客户端、LangChain 这类框架,接入第三方模型的默认方式就是填三个东西:base URL、API key、模型名。只要一个后端是 OpenAI 兼容的,就意味着你不用改任何代码、不用等任何适配,把这三个字段一换,工具立刻换脑。所以老路看到”260 亿参数模型 + 完全免费 + 连代码都不用改”能凑到一起的时候,是有点兴奋的。
1. 注册Kaggle,推荐使用谷歌账号注册即可,没有特殊需要注意的
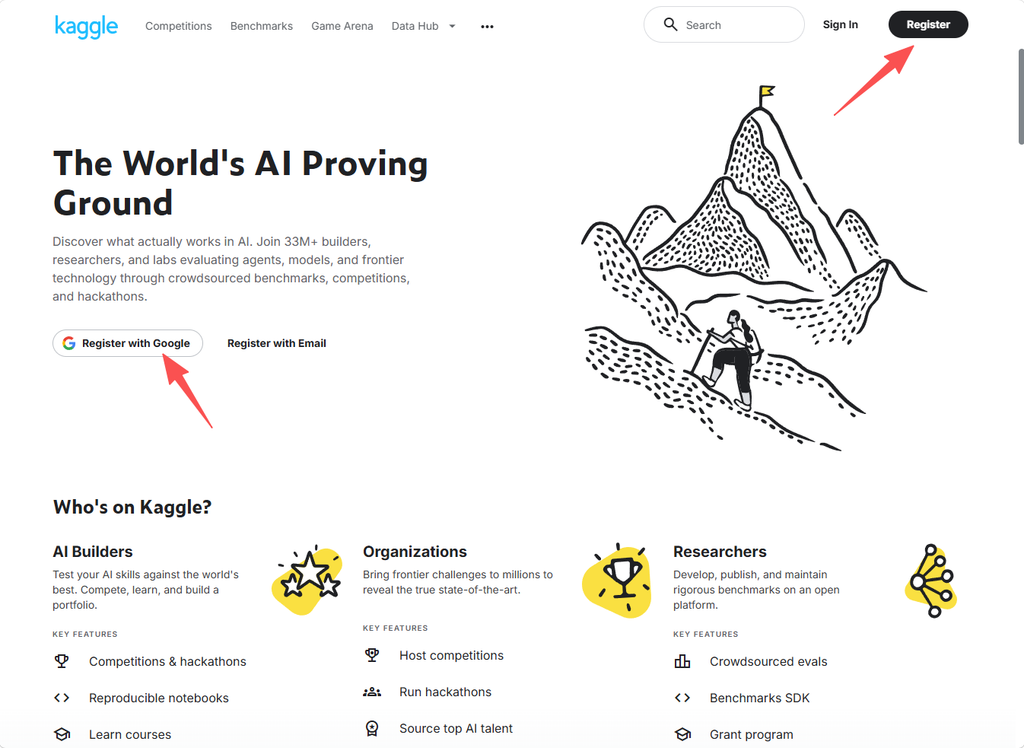
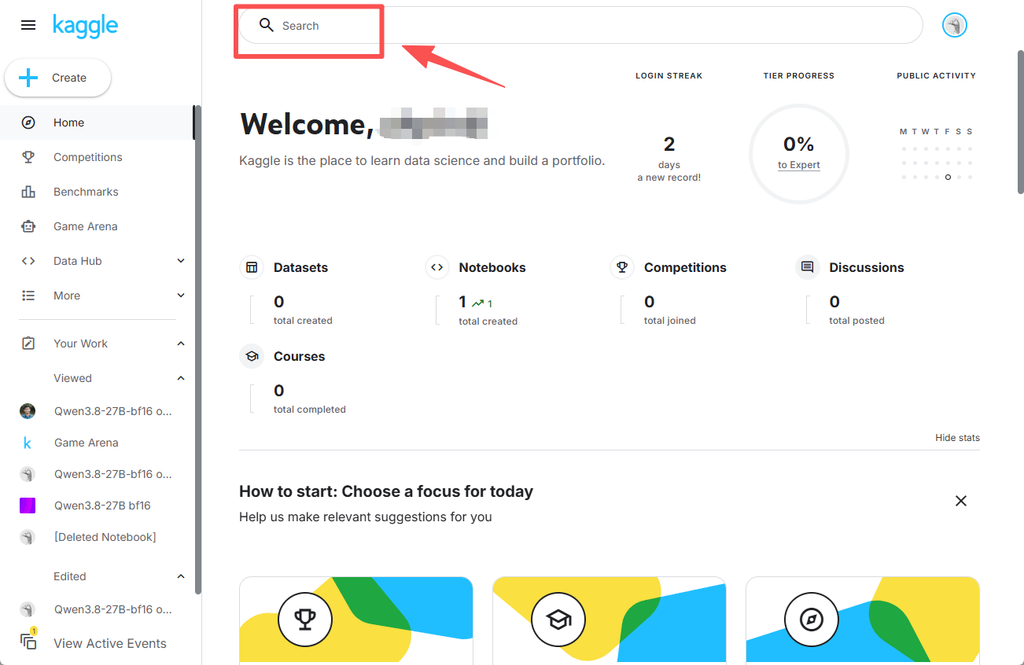
2. 注册完成后进入控制台,复制下方的搜索关键词,然后点击页面最上方的搜索框内进入搜索页进行搜索
qwen3-8-27b-bf16
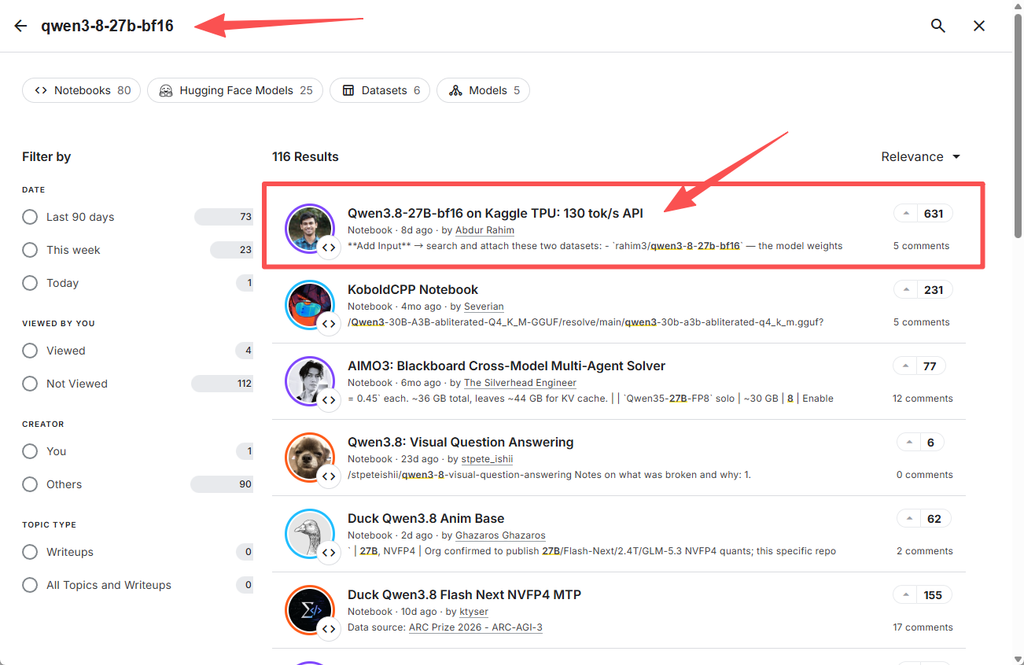
3. 点击搜索结果的第一项,进入大神配置好的镜像
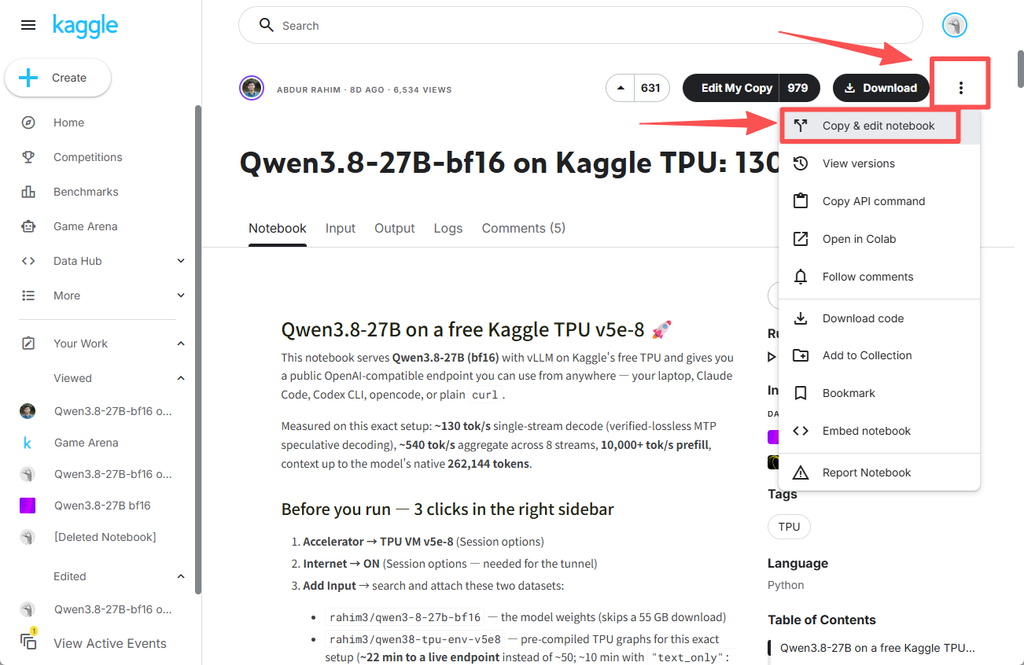
4. 来到大神镜像页面后,点击右上角的三个点,然后点击“Copy & Edit notebook”,把大神的镜像复制到自己的空间内
5. 来到复制好的notebook页面,点击settings,按图中设置选择好
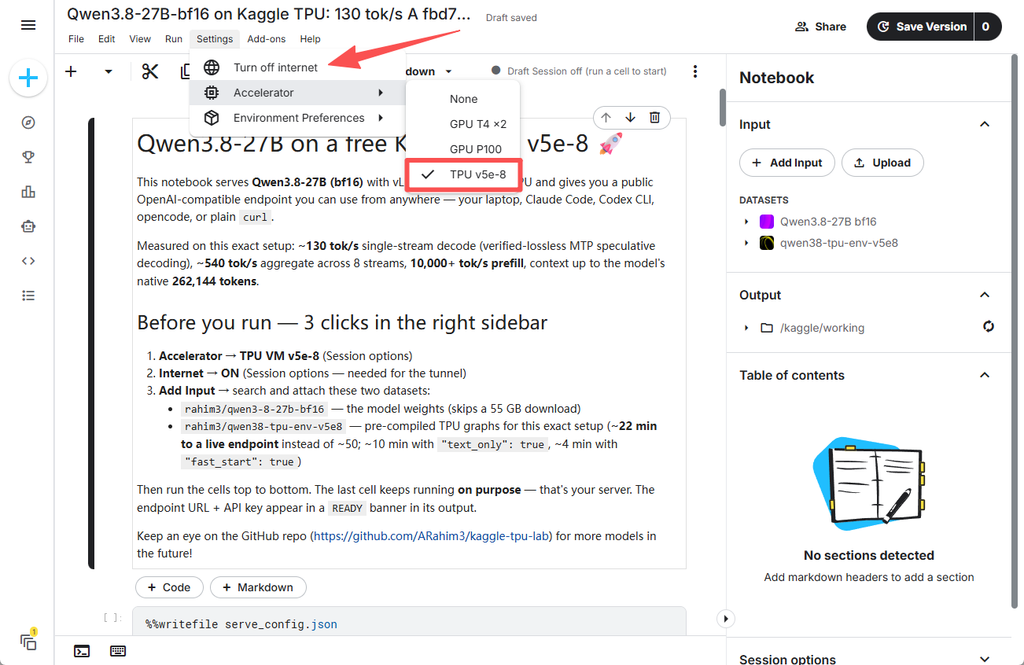
这里要注意,新的kaggle账号,需要进行手机验证后才能选择上图中的TPU v5e-8,没有验证时,这里是灰色的,需要先去个人资料页面进行验证。
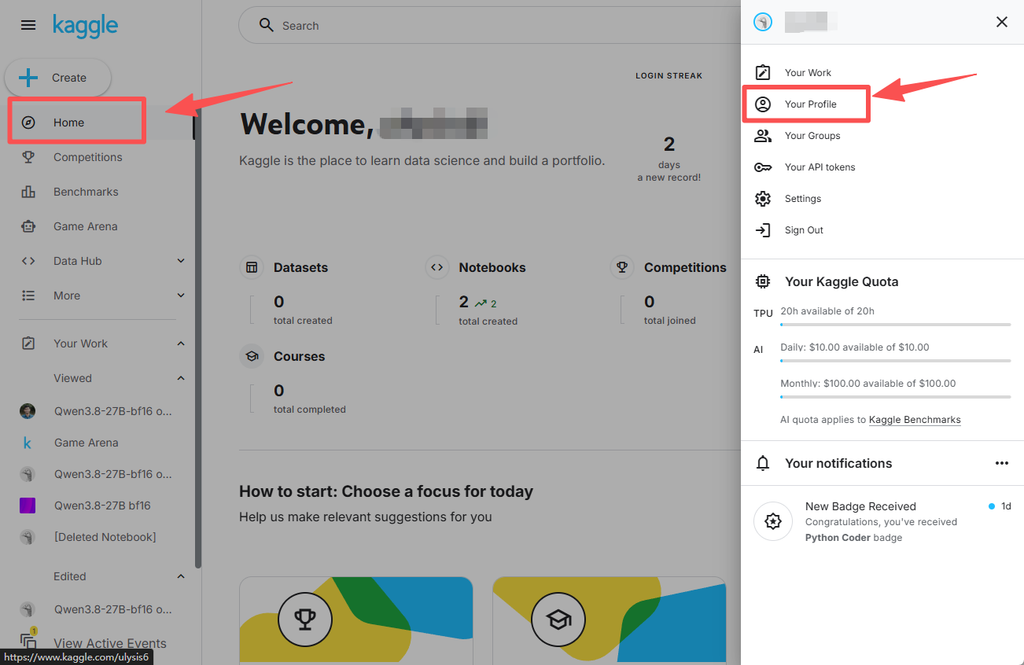
5.1 个人资料页面手机验证,打开左侧菜单,点击“home”,然后点击右上角的头像,点击“Your Profile”
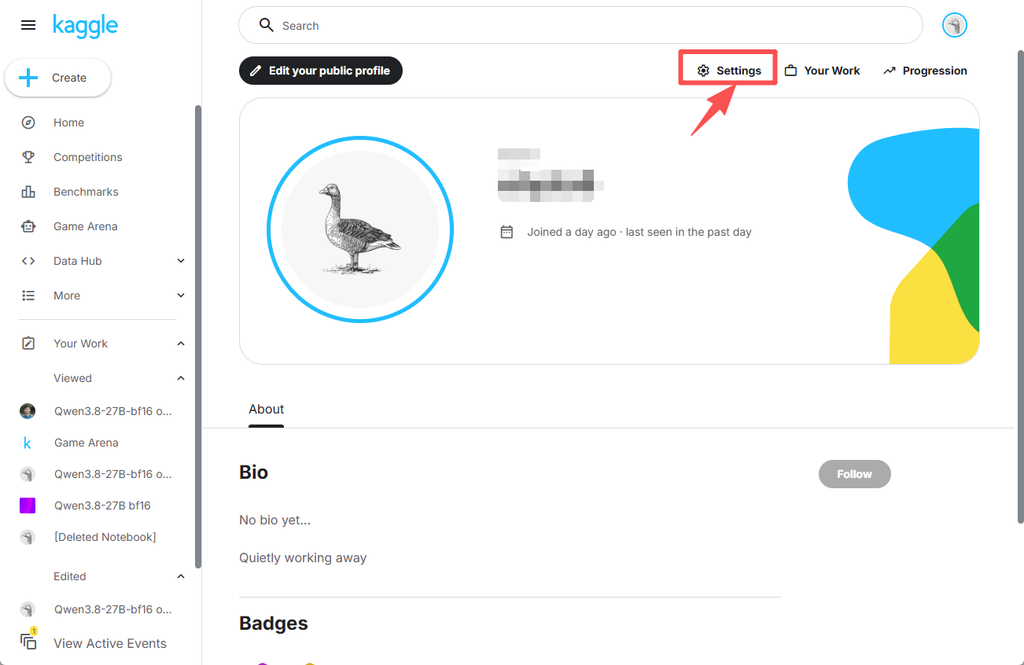
继续点击上方“settings”,进入个人资料设置页面
老路这里已经认证过了,没有认证过的进行验证即可,验证过后回到notebook页面,刚才灰色的选项就可以选择了
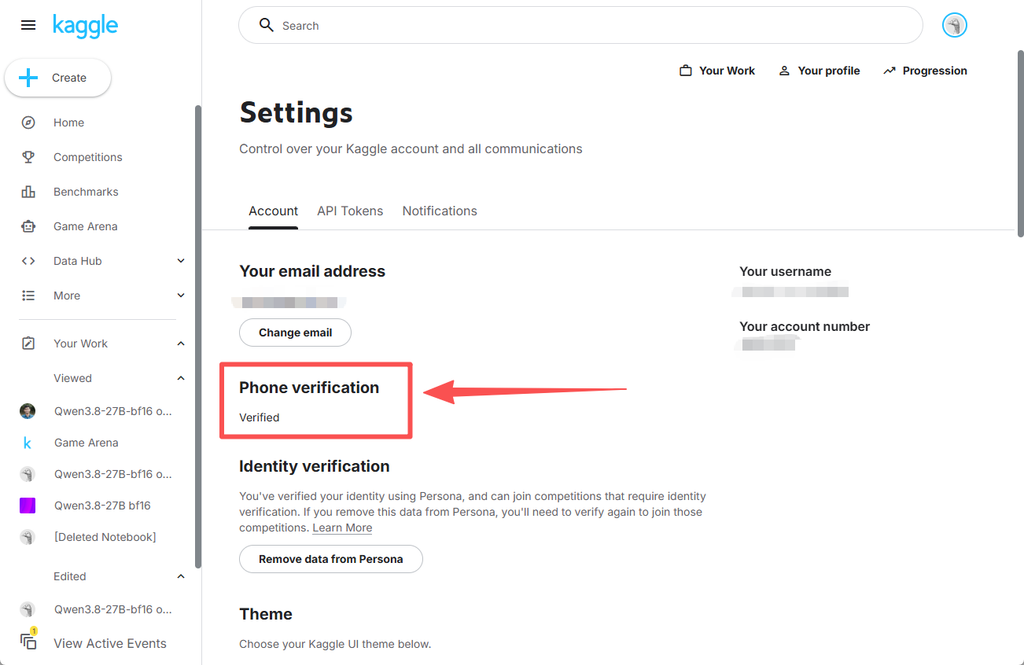
小细节:老路使用了爱沙尼亚和大陆的手机号,都提示不让用手机号验证,点击继续后是用了登录相同谷歌账号的手机进行的人脸验证。
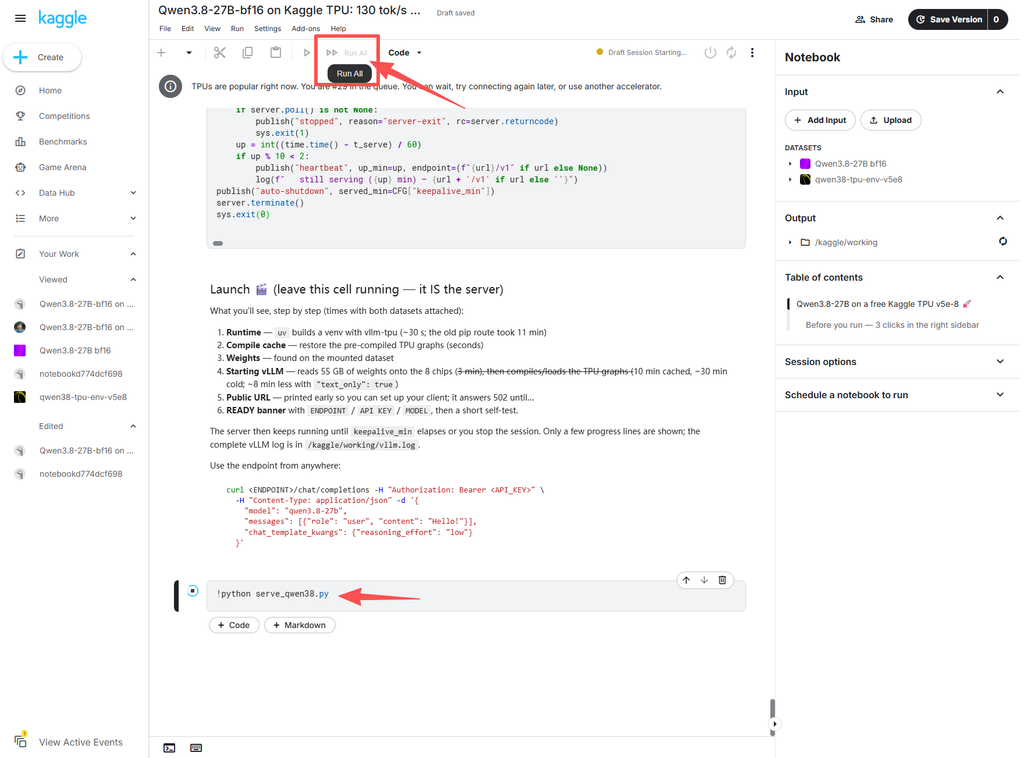
6. 运行部署,先确认Accelerator选择了TPU VM v5e-8,还有Internet是ON,然后点击“Run All”,系统会自动进行部署,这个过程比较慢,老路实测下来要30分钟以上,大家不要着急,开始运行后等着就行。
跑完之后,末尾 cell 的输出里直接打印 endpoint URL 和 API key,形如:
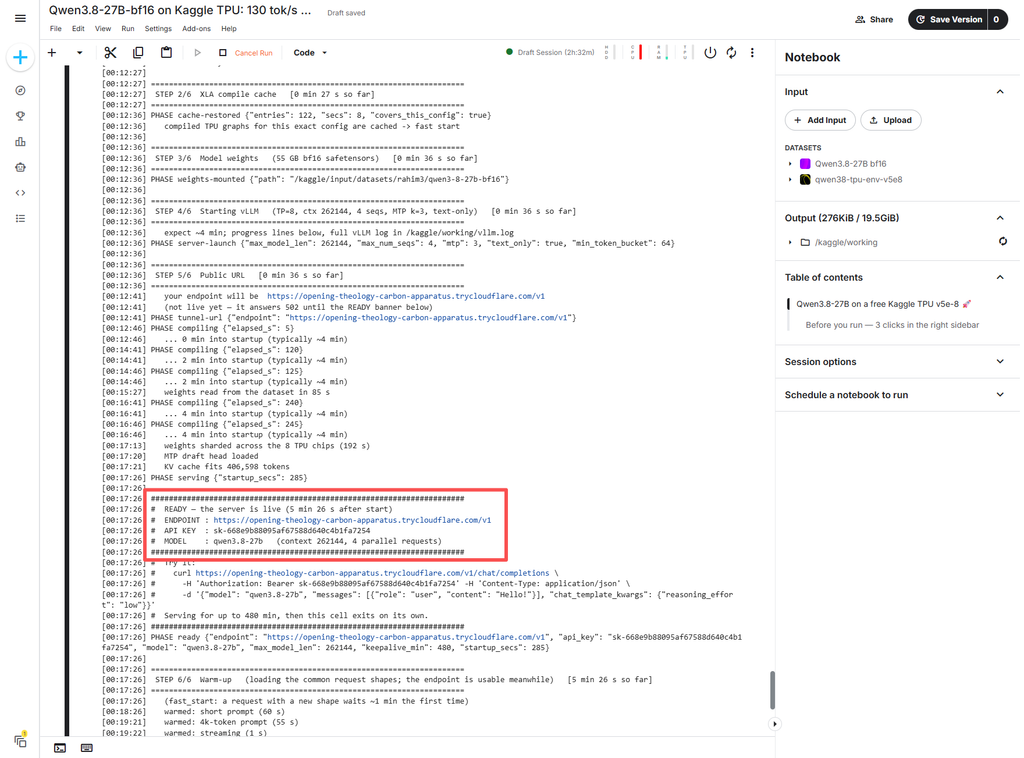
几个官方给的加速开关,老路觉得比默认值实用:
| 参数 | 效果(README 原文) |
|---|---|
--text-only | 跳过视觉塔,快约 10 分钟,代价是不能传图 |
--fast-start | 约 6 分钟就能上线,但罕见请求形状首次会卡约 1 分钟 |
--keepalive-min 60 | 闲置 1 小时自动停,省周配额,最大设置480(8小时) |
接进Agent工具也是标准动作,以CherryStudio为例,新建一个供应商即可
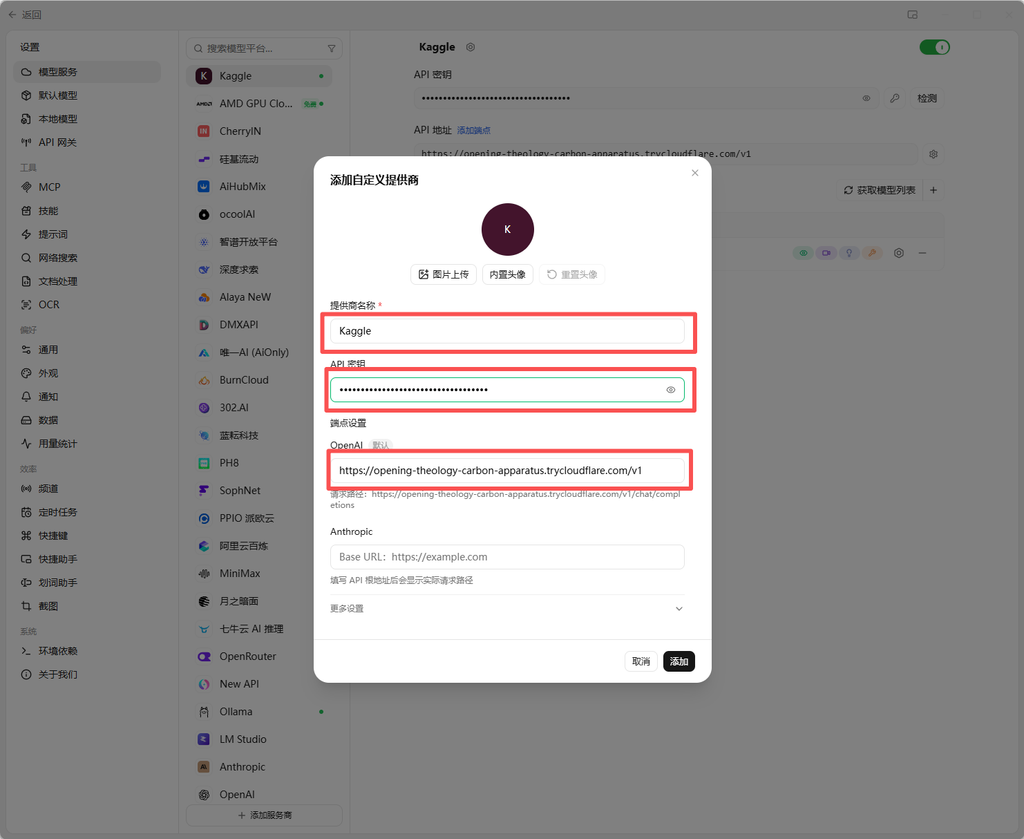
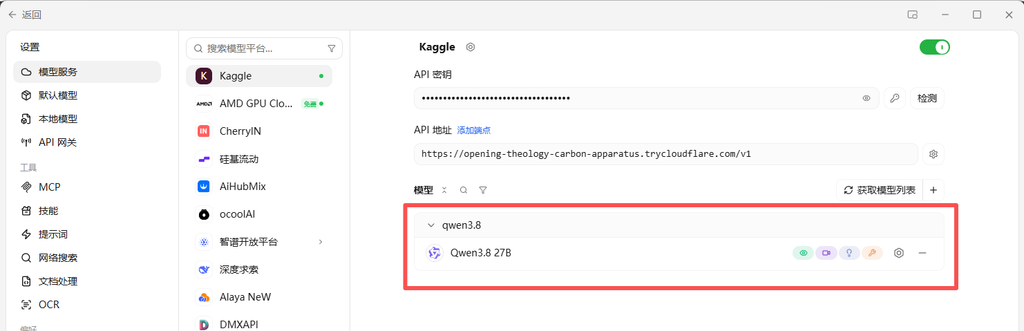
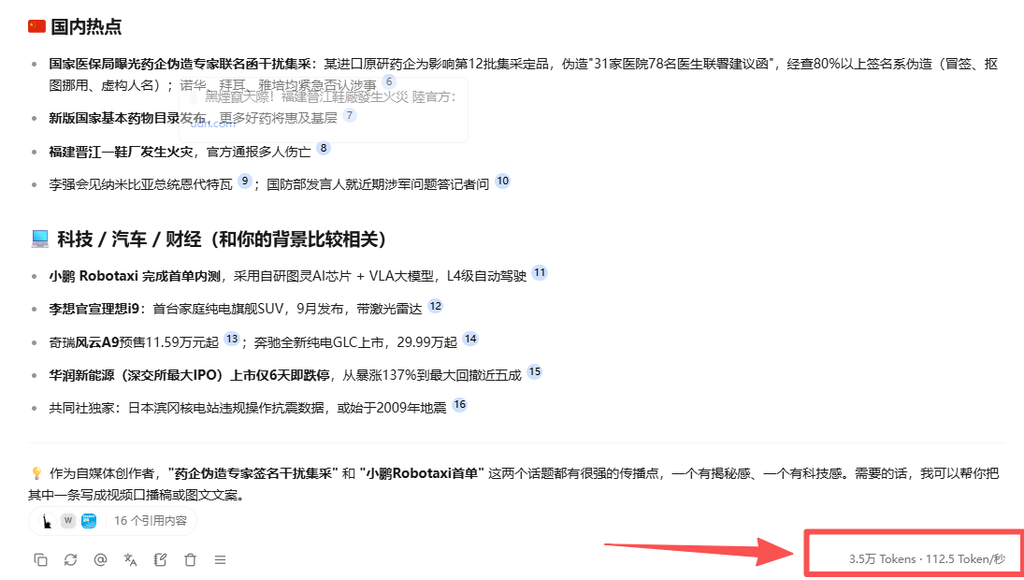
实测响应速度很不错,在80+tokens/秒 到 100+tokens/秒之间,确实要比之前分享的白嫖 AMD 大模型API要快很多
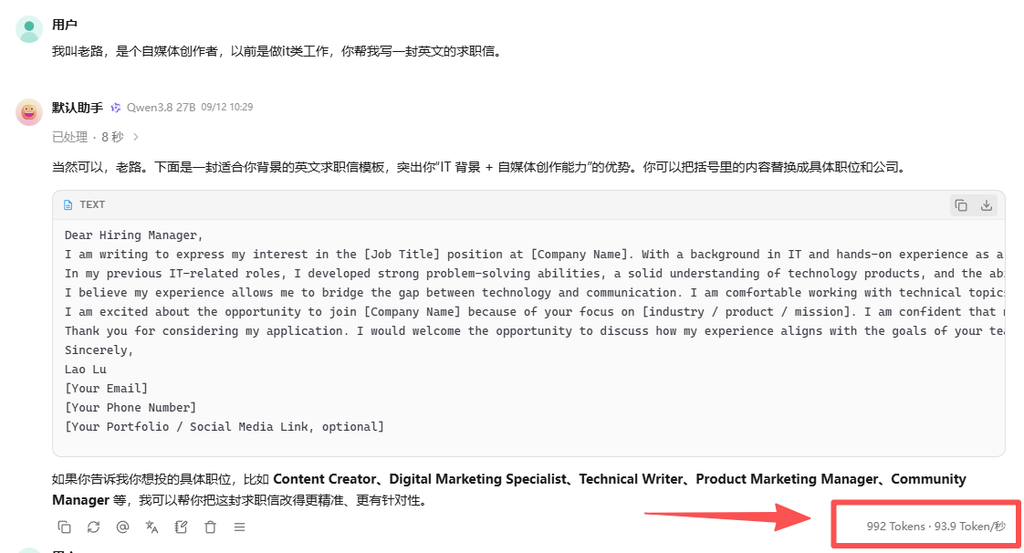
三、避坑指南(这几条不看,白折腾)
- BaseURL(端点地址)和API KEY每次会变,每次都需要重新配置一下。
- 周配额是硬的。20 小时/周、9 小时/次,不是”随便挂”。挂机不关 = 白烧配额,务必开
--keepalive-min自动停。 - 部署环境还是比较慢的。挂了预置环境数据集约 22 分钟,开 fast-start 约 6 分钟,但是同样需要排队等待,实际部署时间会比预想的长。
- 别当生产环境用。这是 Kaggle 免费共享资源,随时排队、随时被回收,把它当”免费实验沙盒”就对了。
最后
免费算力这件事,过去老路的态度是”能白嫖的都不太行,能用的都不免费”。Kaggle 这条是个例外——免费、不绑卡、能跑真 27B、262k 上下文、100+ tokens/秒,还能直接配置到Agent软件。每周 20 小时,对个人折腾党来说,比很多人花钱买的套餐还大方。
代价也很清楚:排队、临时URL/API Key、周配额、不能当生产。把它当免费的实验田,而不是免费的服务器,这条路线就非常香。
一句话:想真正”自己跑”一个 27B、又一分钱不花、又不绑卡,目前 Kaggle 免费 TPU 是唯一像样的答案。免费 API 中转虽然更省事,但你永远只能用它挑给你的那几款模型;Kaggle 这个方案,模型权重是实打实落在你的会话里的。
点击直达:
Kaggle-tpu-lab github仓库(其实用不到,了解即可)
老路实操视频在此~
相关阅读:[[AMD 官方白嫖 DeepSeek V4 Flash API]] · [[AgentScope Platform 免费智能体]]
2 Responses
[…] Kaggle 免费 TPU 跑 Qwen3 27B […]
[…] Kaggle 免费 TPU 跑 Qwen3 27B:白嫖大模型算力 […]