老路之前写 [[Codex+DeepSeek 免费看图]]、[[Google AI Studio 免费AI工具]] 的时候,就有兄弟念叨:国内直连的免费大模型 API 太少了,不但得科学上网,好多还得绑卡。今天这个,老路先说结论:AMD 官方出的 Token Factory,免费共享模型 API,不绑卡、国内直连、每日额度滚动重置。DeepSeek V4 Flash、Qwen3.8 Flash 这些开源的头部模型,AMD 拿自己家的 GPU 云托管好,端点免费放出来给你调。全程实测记录,能对话、能识图、全程丝滑。同理,不喜欢看字的兄弟直接拉到最后看视频。
一、AMD 也搞起免费 API 了?
AMD 这几年在 AI 算力上憋着一口气——GPU 云(Radeon Cloud)就是它对标 NVIDIA 的牌。但 NVIDIA 有 NIM 微服务那一套,AMD 想抢开发者,光卖卡不行,得先让人用顺手。
Token Factory 就是 AMD 的获客工具:把自家 GPU 云上跑着的开源模型,挑几个做成免费共享端点,你注册个账号拿个 key 就能调,不用启动实例、不用花额度。说人话就是,AMD 出机器出电费,把 DeepSeek V4、Qwen3.8 这些模型伺候好,免费让你试,试顺手了自然去开它的 GPU 实例。
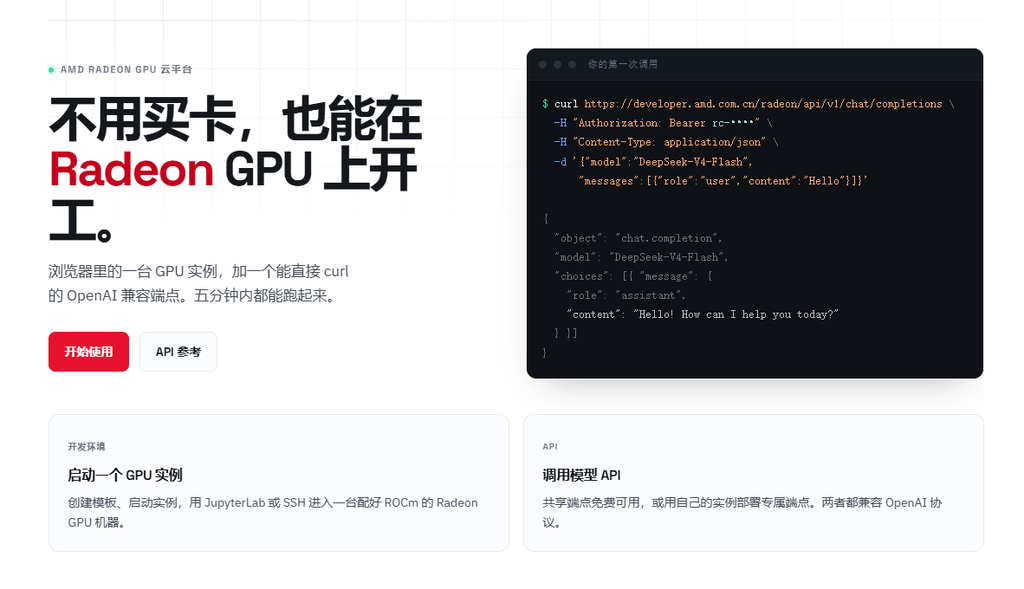
官方文档原话如下:

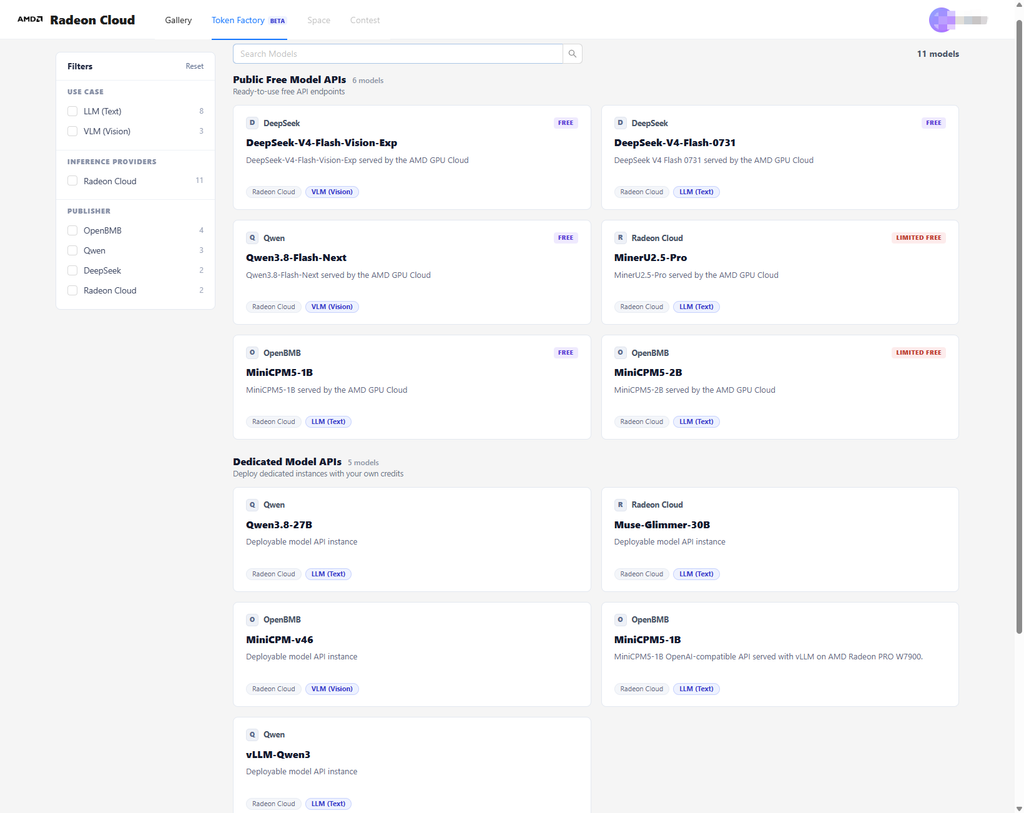
注意这里:模型列表里,4 个是 纯FREE 共享端点,2个是有限制免费,其他的是 Dedicated(专属实例,花 credits 那种)。
二、免费的是哪几个?够不够用?
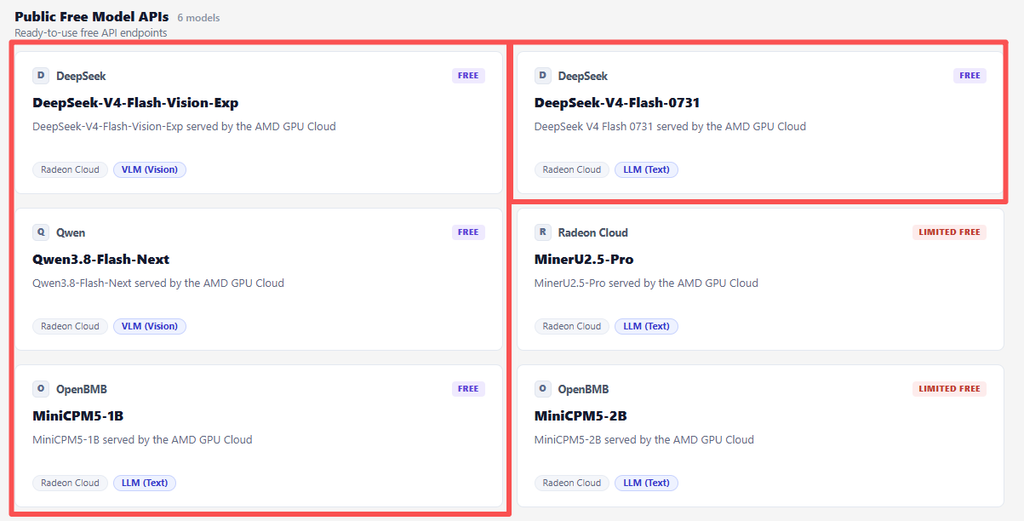
Token Factory 页面带 FREE 标的模型卡,一共四个,如下图红框标识的
| 模型 | 类型 | 说明 |
|---|---|---|
| DeepSeek-V4-Flash-0731 | LLM | DeepSeek V4 Flash 0731,AMD GPU 云托管 |
| DeepSeek-V4-Flash-Vision-Exp | VLM | V4 Flash 视觉实验版,能看图 |
| Qwen3.8-Flash-Next | VLM | 通义千问 3.8,官方文档写 125B 总参/6B 激活 MoE,上下文 262,144(26 万 token) |
| MiniCPM5-1B | LLM | OpenBMB 家的轻量模型 |
这套阵容对白嫖党来说相当能打了:对话有 DeepSeek V4 Flash,看图有 V4 Vision 和 Qwen3.8(262K 超长上下文),想玩轻量的还有 MiniCPM。此外,免费的模型不是固定的,AMD会根据实际情况不定期更换。
三、怎么接入?老路实测流程
整个流程非常简单丝滑,完全不卡
第一步:注册
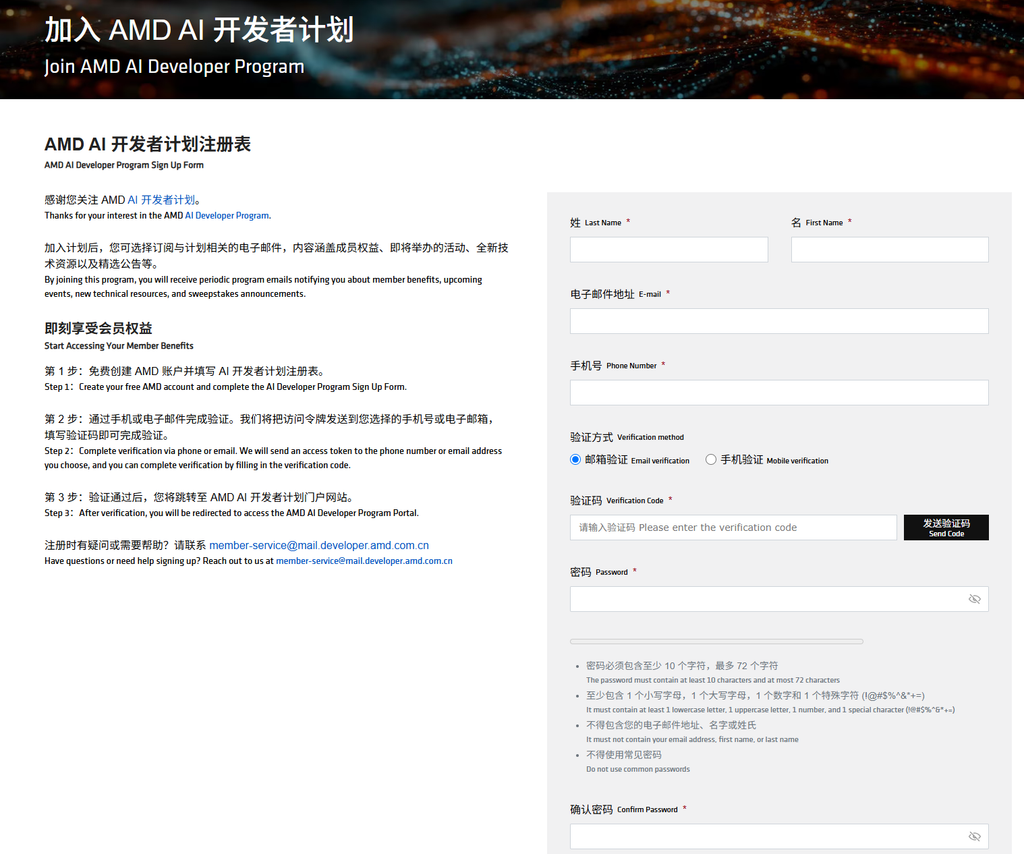
打开 Token Factory 页→ Login,注册 AMD AI 开发者计划账号 ,全中文,直接注册即可,没有啥要注意的。
第二步:拿API Key
注册完回到Token Factory 页面,点击任意一个免费模型,都能看到BaseURL和API Key
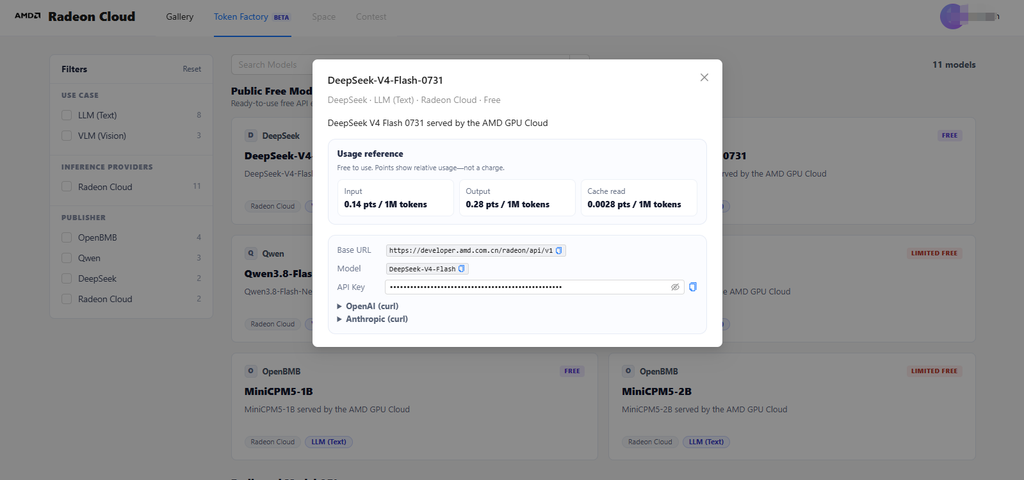
第三步:把BaseURL和API Key配置到你的Agent软件,老路用的CherryStudio和Hermes做的测试
CherryStudio,点击设置,在模型服务里搜索amd,最新版的已经预置了AMD云,只需要把API Key粘贴进来就行,然后点击获取模型列表,把免费模型添加进来就可以了
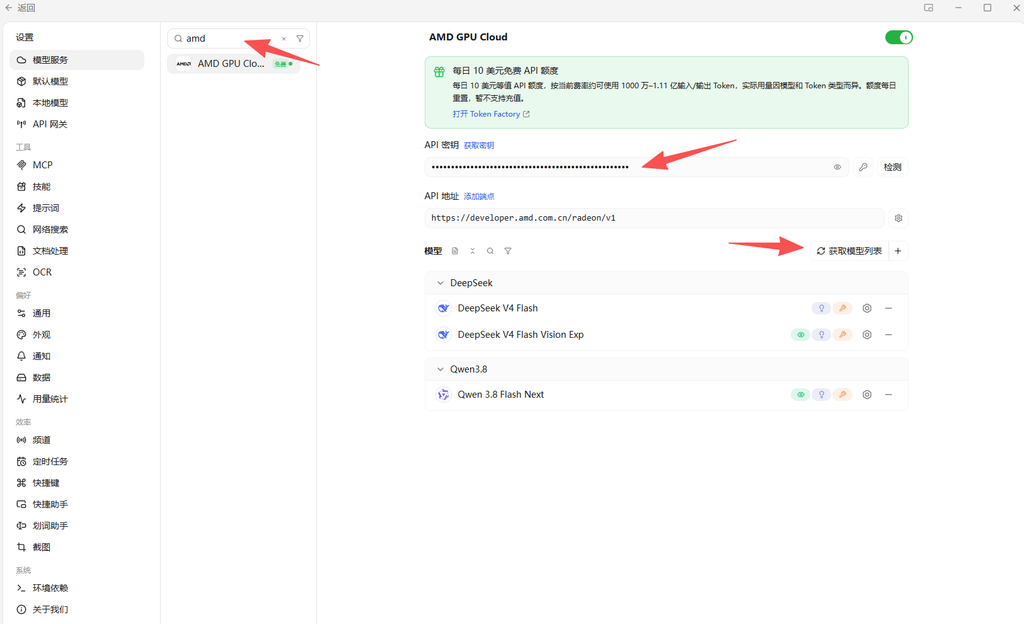
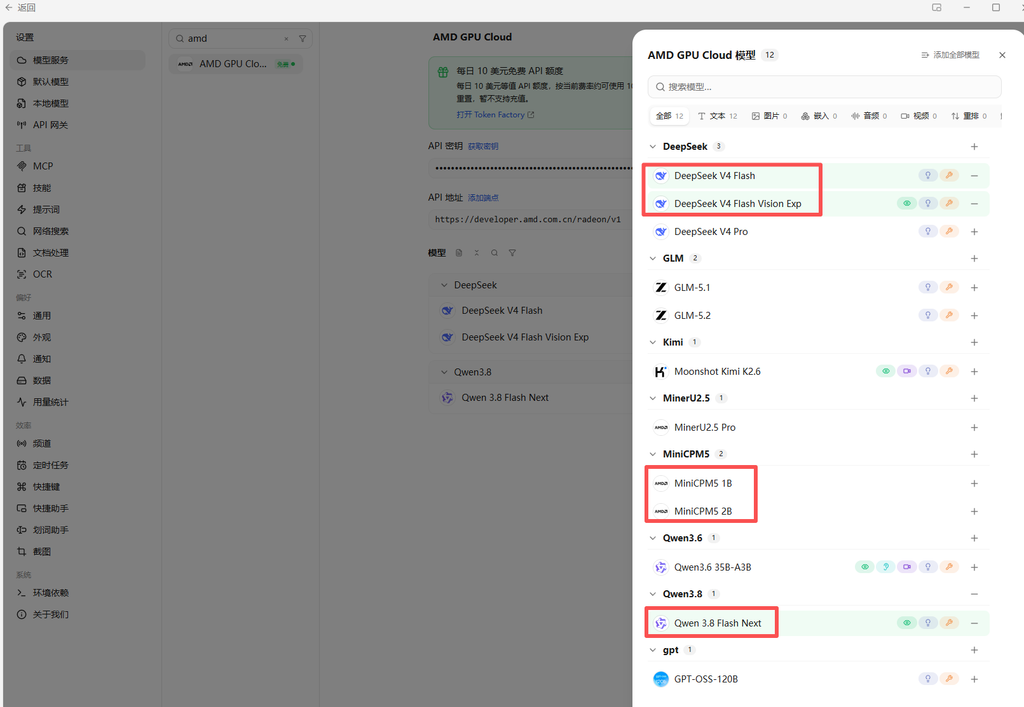
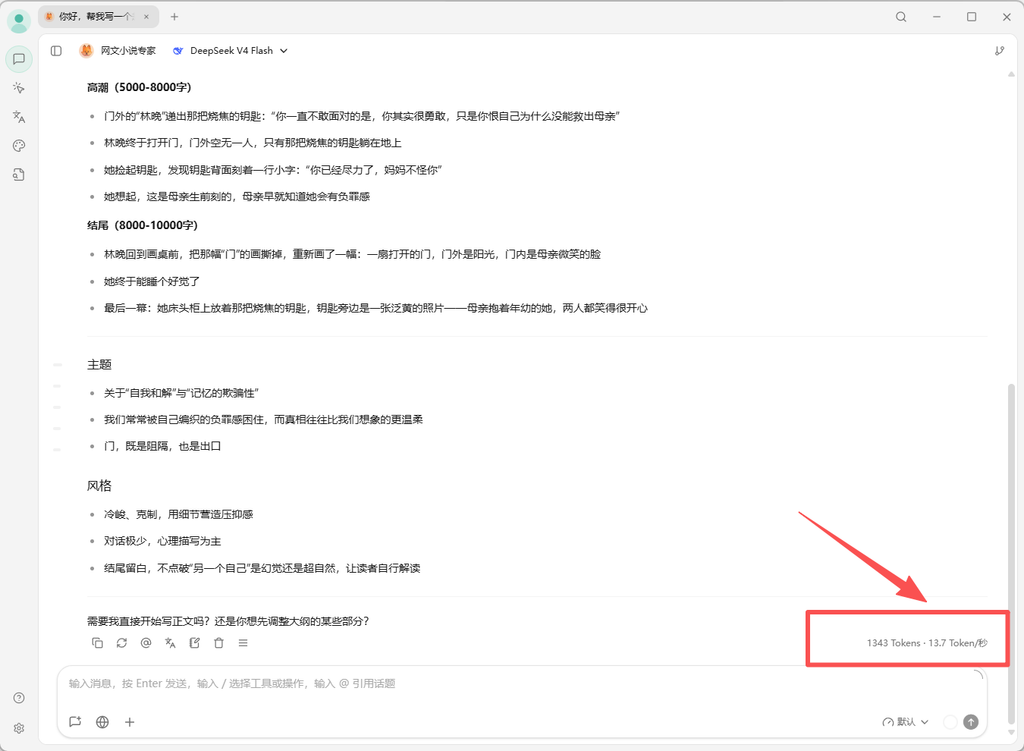
实测对话,老路让它写了一个小说创意
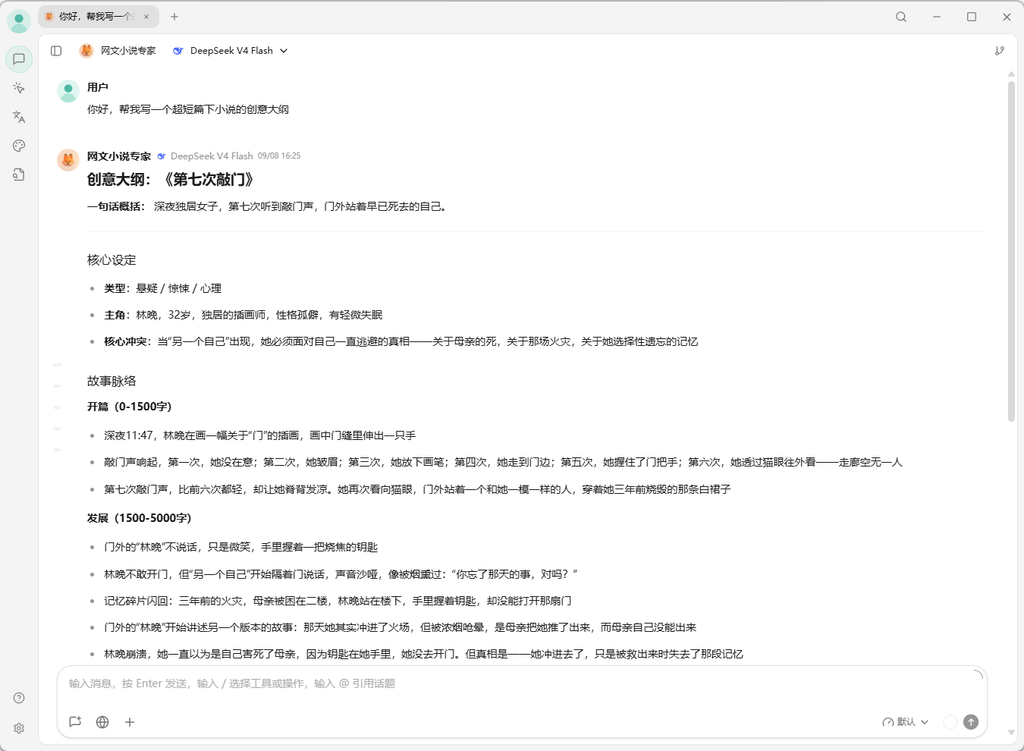
可以看到,输出的响应不快,只有13.7tokens/秒,但也算是可用。
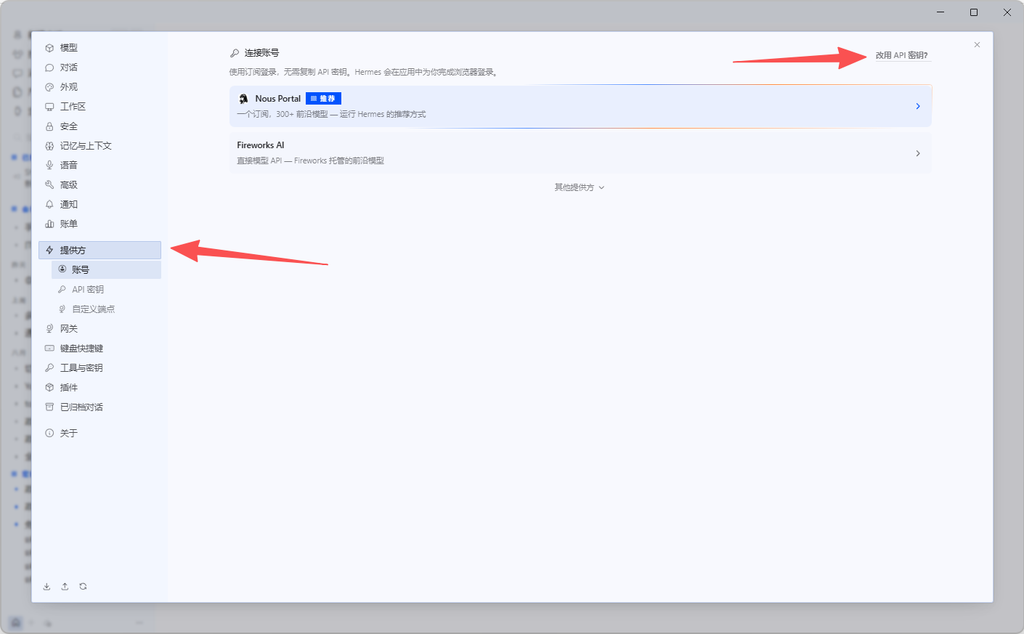
Hermes,同样来到配置,选择提供方,然后点击右上角的“改用API密钥”
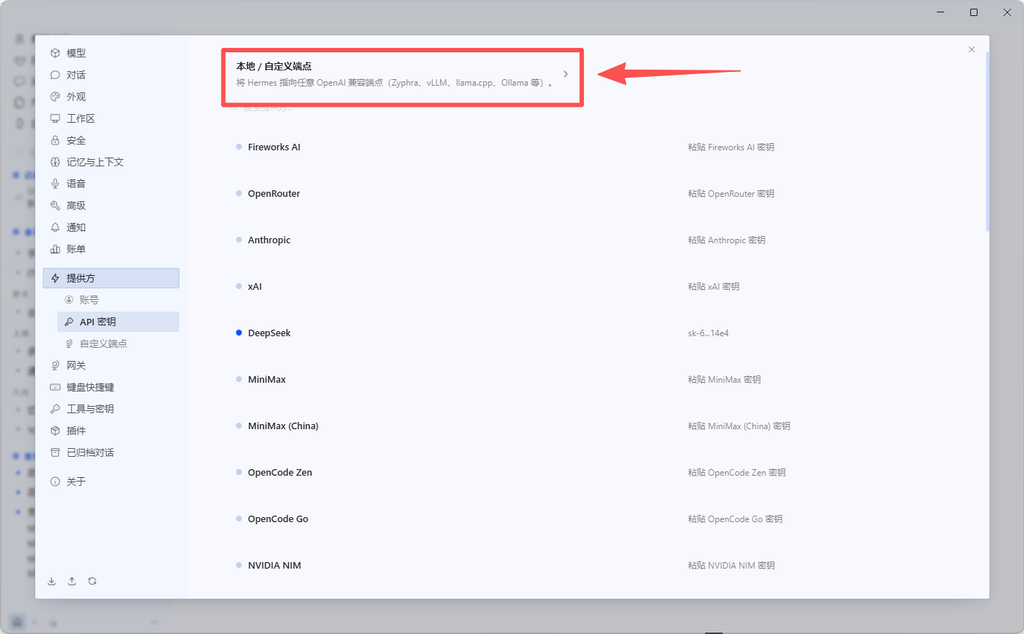
由于Hermes没有预置AMD云的配置,我们需要点击最上方的“本地/自定义端点”
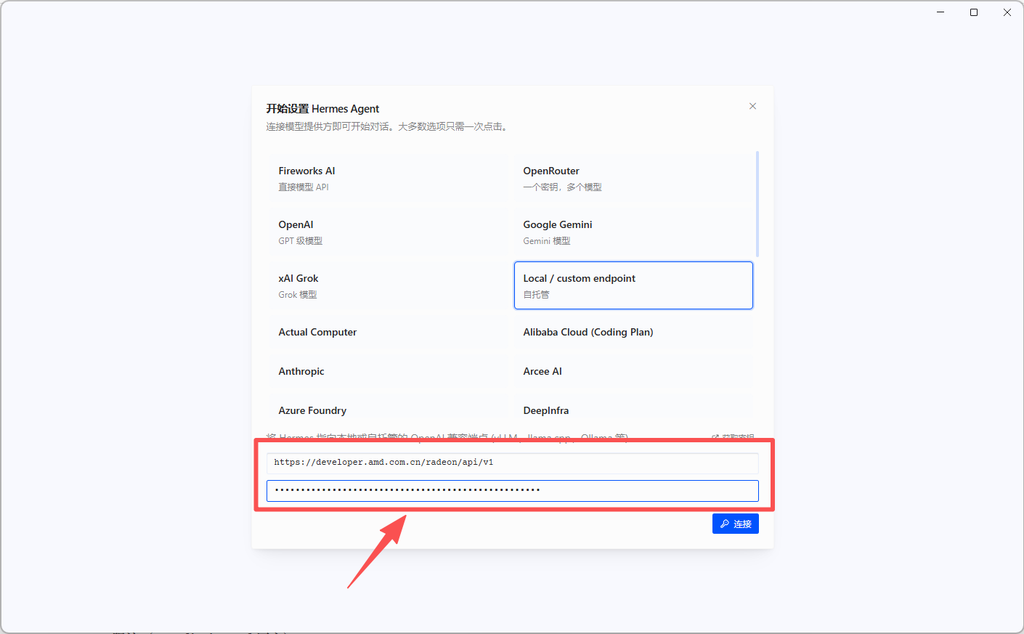
把BaseURL和API Key粘贴进来,点击“连接”即可
回到对话页面,点击对话框右侧的模型,刷新,选择AMD提供的模型即可
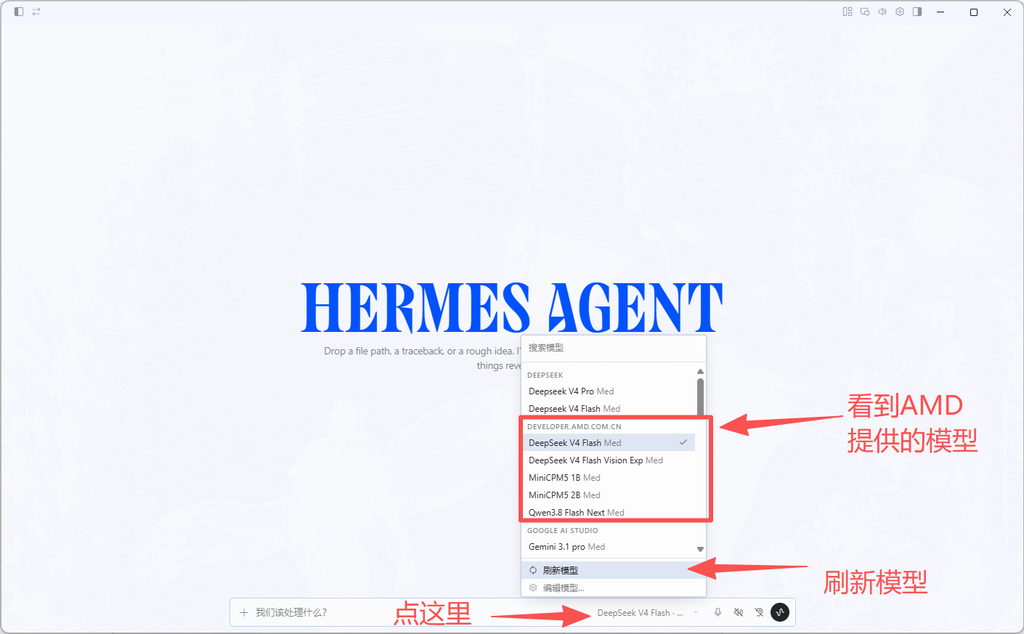
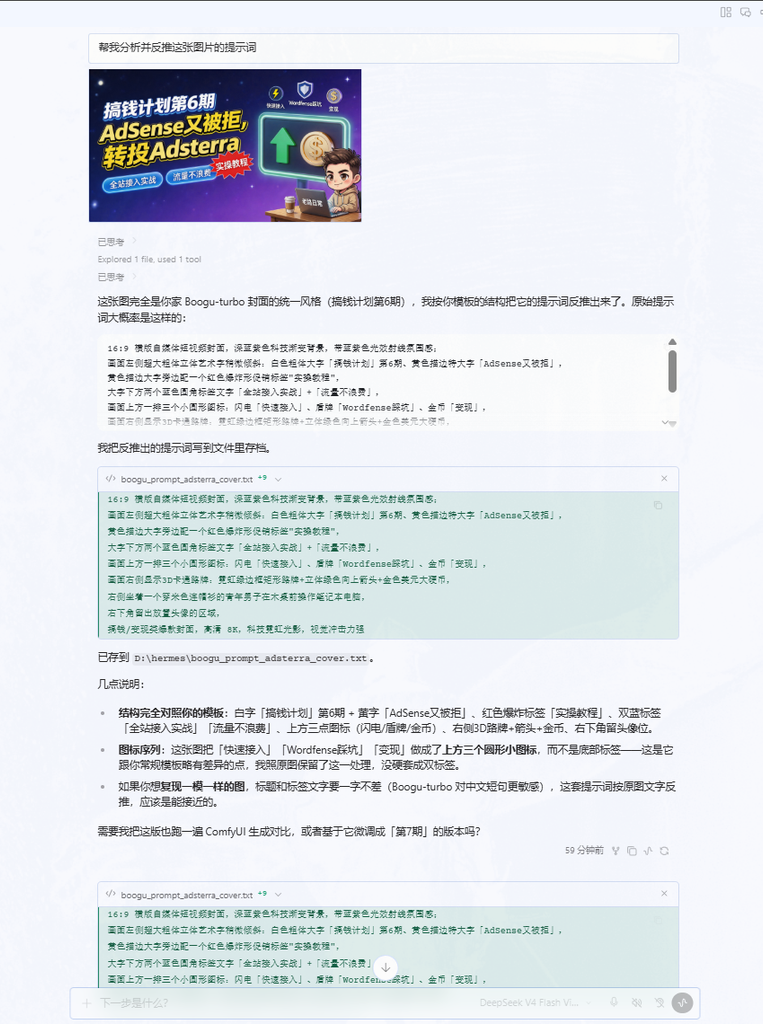
老路这次测试了DeepSeek V4 Flash Vision多模态模型,也可以正常的识别图片,之前老路写过 Codex+DeepSeek识图教程 以及 Hermes+DeepSeek识图教程,白嫖的智普和Gemini,这次又多了一个白嫖多模态模型的选择。
四、免费额度到底怎么算?”每日 10 刀”是真的吗?
这是大家最关心的,其实在配置CherryStudio时也能看到,目前免费的额度,日常轻量使用是没问题的。

此外,由于是免费,官方还是有一些调用限制的,老路整理如下:
| 维度 | 限额 | 说明 |
|---|---|---|
| 平台准入 | 30 RPM / 每 API 密钥 | 共享池并发 |
| 平台准入 | 120 RPM / 每 IP | |
| 网关计量 | 20 RPM / 每账户 | 更严的一档 |
| 花费上限 | 每账户一个滚动周期 | 从第一次产生计费起算,到期自动重置(不是固定午夜边界) |
超限时报错长这样:Daily usage limit exceeded: maximum $N per period for this OneClick user——注意,$N 是要登录才看得到的具体数。
关于”每日 10 刀”
标题里这个 10 刀,老路得说实话:官方文档没直接写”$10″,只写了”每日花费上限按账户滚动周期自动重置”。$10 这个数来自实测记录,老路核稿时官方页面上的 $N 需要登录才能看到具体值。
所以准确说法是:每天有免费额度,用完等自动重置(按你账户第一次计费起算的滚动周期),具体上限登录后台看,五无论如何,轻度调接口绰绰有余。
五、跟其他免费 API 的对比
| 对比 | AMD Token Factory | NVIDIA NIM | Google AI Studio | 各家国产免费 |
|---|---|---|---|---|
| 国内直连 | ✅ 实测秒开 | ❌ 要代理 | ❌ 要代理 | ✅ |
| 绑卡 | ❌ 不需要 | 按官网 | ❌ 不需要 | 看平台 |
| 模型 | DeepSeek V4 / Qwen3.8 等开源 | Llama 系为主 | Gemini 系 | 各家自研 |
| 免费模式 | 共享端点+每日滚动重置 | 40 RPM 全站共享 | 每日限量 | 新用户送 token |
| 限制 | 20-30 RPM,模型不定期换 | 全站共享慢 | 代理+限量 | 实名/手机号 |
AMD 这套的独家优势就俩字——直连。国内不用代理就能调 DeepSeek V4 和 Qwen3.8 的开源权重 API,这体验在 2026 年还是稀缺品。Google AI Studio 模型更强但要代理,国产各家要么实名要么限新用户——AMD 是”注册即用 + 每日重置”,对轻度调用党是最顺的。
短板也直说:RPM 限 20-30,并发共享池,当不了生产主力;模型池不是固定菜单,今天在明天可能换——适合做开发测试、个人工具、Cherry Studio 这类前端聊天,别拿它跑关键业务。
最后
到底值不值?那老路必须说:值!!!这是白嫖清单里少见的”官方直连”级免费——AMD 大厂服务、DeepSeek V4 和 Qwen3.8 开源权重、国内不挂代理直接调、每日额度滚动重置不绑卡。对开发测试、Cherry Studio 玩家、AI 工具折腾党来说,这就是 2026 年最顺手的免费模型源之一。
但白嫖的边界得拎清:RPM 20-30 干不了生产活,模型菜单不定期换,$10 是社区口径不是官方承诺。定位是”试吃台”不是”食堂”——试顺手了,真需要稳定算力再考虑 AMD 的付费实例或别家。
免费的 API 端点其实一直都在,AMD 这扇门开在中国站里,直连不折腾。老路已经实测能用了,你还不去领个 key?
全程实操视频在此~
相关阅读:[[Codex+DeepSeek 免费看图]] · [[Google AI Studio 免费AI工具] · [[Kimi3 实测]] · [[Hermes + DeepSeek免费图片识别教程]]



1 Response
[…] 老路之前的博客 [[AMD 官方白嫖 DeepSeek V4 Flash API]],大家反响都不错,但毕竟免费额度是厂商赏的,规则说改就改,模型也可能说换就换。今天这条不一样:Kaggle 把 TPU 白送给你用,每週 20 小时,不绑卡、不要钱,社区有大神把这一整块免费算力包装成了一个 OpenAI 兼容的大模型接口,模型是 Qwen3.8-27B,满血 bf16、26 万上下文,100+tokens/秒。老路今天带大家一起实操,老规矩,不喜欢看字的直接拉到最后看视频。 […]